Jevで何が作れる?9つのawesomeリストから用途と実例を整理してみた
Jevで作られたものを探していると、ブラウザを操作するデモがよく目に入ります。動きが速く、つい見てしまうのですが、ほかにどんな用途があるのかも気になりました。デモをいくつか見るだけでは、全体像まではつかみにくいんですよね。
そこで、GitHubにある9つのJevのまとめリストを調べてみました。READMEに載っているリンクを集め、重複などを整理したところ、1,186個のリポジトリアドレスが残りました。
この数字には、実験やライブラリ、既存ソフトへの組み込み、別実装などが含まれています。完成したアプリが1,186個ある、という意味ではありません。それでも、用途ごとに読み進めると「こういうところにも使えるのか」と思う例がいくつもありました。
まずはリスト同士の重なりや用途の分布を見てから、具体的なプロジェクトを紹介します。あとで気になったものを探し直せるよう、最後に用途別の早見表もまとめました。
この記事は、ShinがDEVに公開した英語記事を、日本語で読みやすいように書き直したものです。集計日は2026年9月21日です。
そもそも、Jevには何を任せるのか
たとえばメールなら、「返信を書く」のと「返信が必要かどうかを決める」のでは、必要な処理が違います。
今回見たプロジェクトでは、どのボタンを押すか、資料が質問に関係しているか、どのAIモデルに依頼を回すか、といった判断をJevに任せています。
その判断を受けて、実際に処理を進めるのは周りのアプリです。通知文が必要なら、文章を生成するモデルに書いてもらえます。各プロジェクトも、アプリのどの判断をJevに任せているかに注目すると、狙いがつかみやすくなります。APIの仕組みを知りたい方は、TypeSafeの公式ドキュメントを見てみてください。
まとめリストを1つ見れば、だいたいわかる?
調べてみると、リストごとに載っているものは意外と違いました。
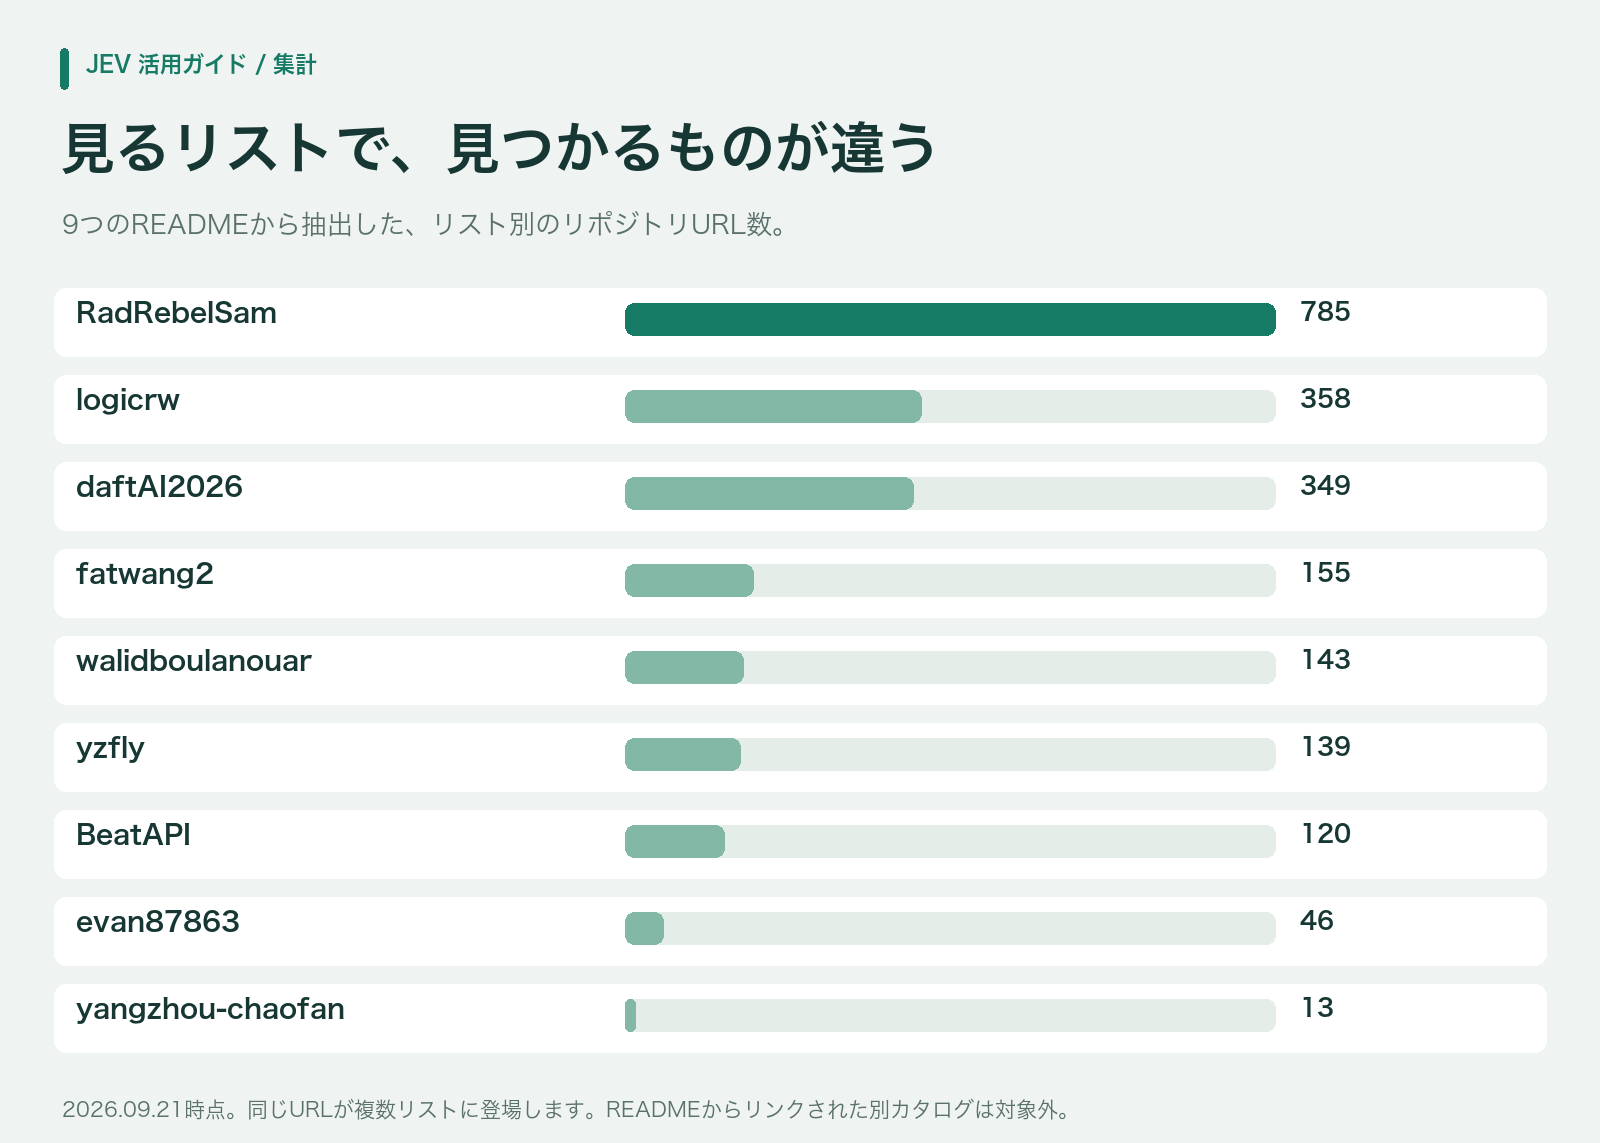
9つのREADMEの掲載数を足すと、合計は2,108件です。同じリポジトリが3つのリストにあれば、ここでは3件と数えています。アドレス単位で重複を除いた数が、先ほどの1,186件です。
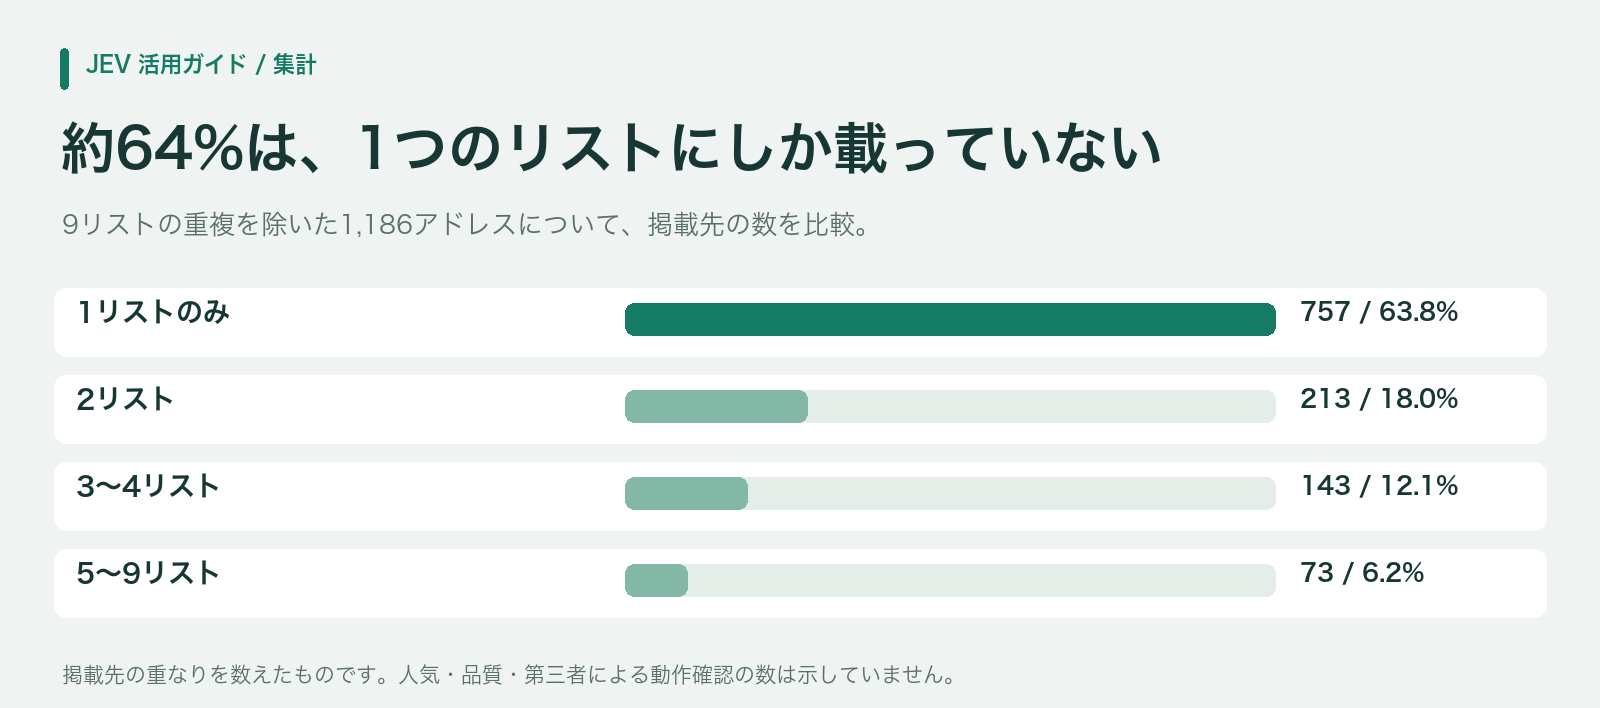
そのうち757件、全体の63.8%は、1つのリストにしか載っていませんでした。 2つに載っていたものは213件で、9つすべてに載っていたものは3件だけです。
つまり、最初に見るリストによって、出会うプロジェクトも変わります。今回調べたREADMEの掲載数は、最大で785件、最小で13件でした。ただし、READMEから別の大きなカタログへ案内しているものもあります。そのリンク先までは今回の集計に含めていません。
複数のリストに載っているからといって、それだけでおすすめとは言い切れません。同じ場所から情報を集めている可能性もありますし、5つに掲載されていても、5人が動作確認したとは限らないためです。
用途を分けると、ブラウザ操作以外がかなりある
集計で迷ったのは、カテゴリーの扱いでした。あるリストでは「SDKs and clients」の中に、Snakeのゲームやメールアプリまで入っていました。カテゴリー名が同じでも中身がそろっているとは限らず、そのまま足し合わせるのは難しそうです。
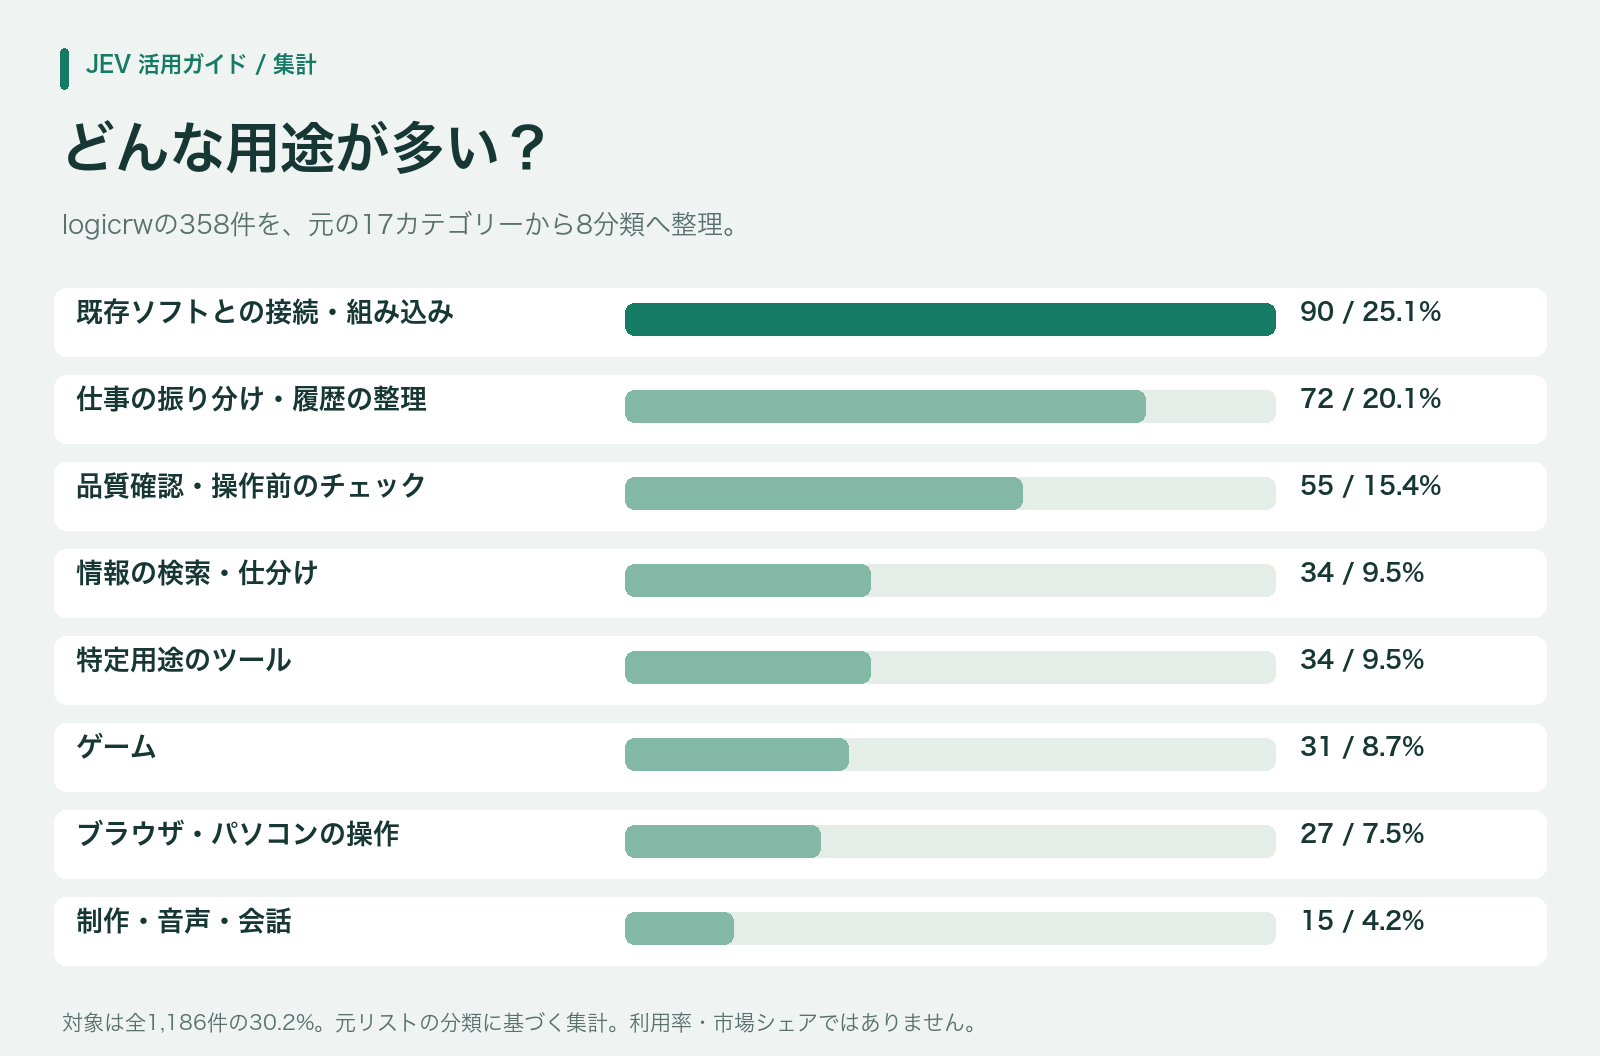
そこで用途の集計には、logicrwのリストにある358件すべてを使いました。元の17カテゴリーを、意味の近い8つにまとめています。各項目を数える先は、1つのカテゴリーに限定しました。
| 用途 | 件数 | 358件に占める割合 |
|---|---|---|
| 既存ソフトとの接続・組み込み | 90 | 25.1% |
| 仕事の振り分け・履歴の整理 | 72 | 20.1% |
| 品質確認・操作前のチェック | 55 | 15.4% |
| 情報の検索・仕分け | 34 | 9.5% |
| 特定の業務・用途に向けたツール | 34 | 9.5% |
| ゲーム | 31 | 8.7% |
| ブラウザ・パソコンの操作 | 27 | 7.5% |
| 制作・音声・会話 | 15 | 4.2% |
一番多かったのは、既存のソフトや開発環境にJevをつなぐものでした。仕事の振り分けや履歴整理も多く見られます。一方、最初に目を引いたブラウザ・パソコン操作は、このリストでは7.5%でした。
この分類で扱っているのは、**全1,186件のうち30.2%**です。残り828件は用途の集計対象にしていません。また、元リストの分類をまとめたもので、僕が358件のコードをすべて確認したわけではありません。あくまで、このリストに何が載っているかを見るための数字です。Jev全体の利用率や市場シェアを表すものではありません。
ここからは、使い方を想像しやすい例を紹介します。自分のOpenPokeのfork以外は、ドキュメントを読んで確認した範囲です。すべてを手元で動かしたわけではありません。フロー図も仕組みを説明するために作ったもので、実行結果のスクリーンショットではありません。
1. 通知する前に、メールを仕分ける
「明日の打ち合わせ、この時間で大丈夫ですか?」というメールが届いたとします。アシスタントが通知文を書く前に、まず、そのメールを今知らせる必要があるかどうかを決めます。
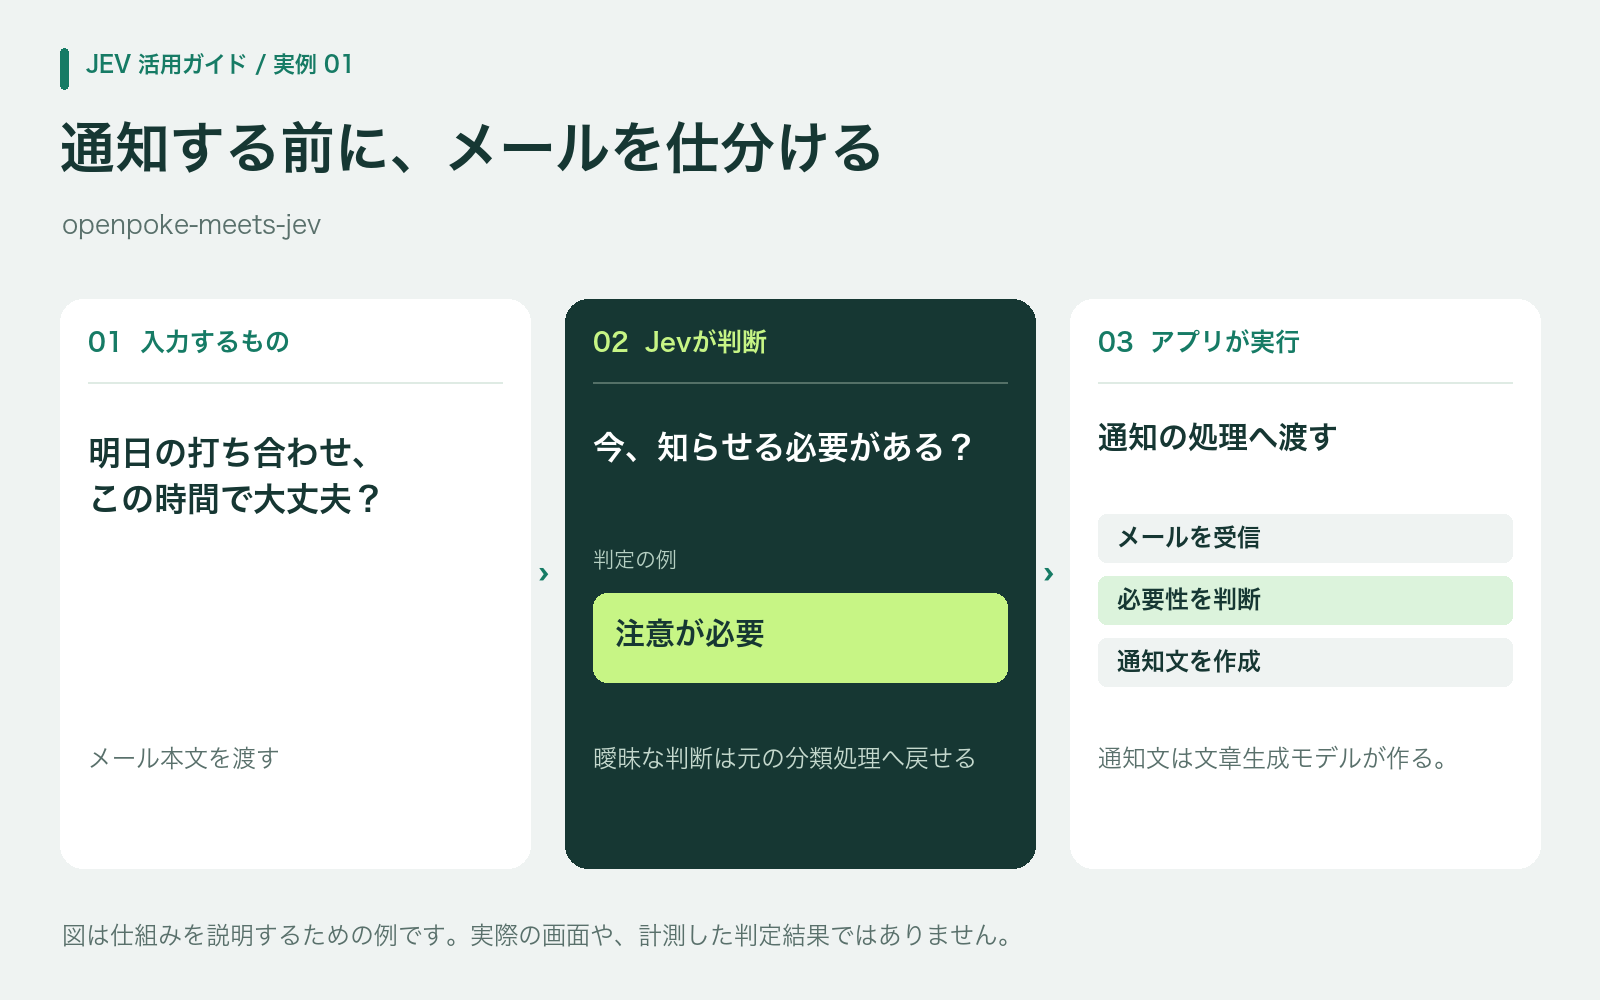
openpoke-meets-jev は、Shlok KhemaniのOpenPokeを僕がforkしたものです。メールの仕分けをJevに任せ、その後の通知文は文章生成モデルが作ります。判断が曖昧な場合には、元の分類処理に戻す経路も用意しています。
僕が行った小規模な比較テストでは、仕分けの平均応答時間がSonnet 4の2,452msから、Jevの424msになりました。測ったのは仕分けの呼び出し部分で、アシスタント全体の処理時間ではありません。
比較結果と、テスト中に見つかったフィルター方針の失敗は、前の記事に書いています。リポジトリを読むなら、READMEのA/B結果と、判断が曖昧な場合の処理から見ると流れを追いやすいと思います。Jevを有効にするとメール本文をTypeSafeへ送るため、試す際には外部へ送ってよいメールを選んでください。
図にあるメールと判定は、この流れを説明するための架空の例です。
2. ウェブサイトの「次に押す場所」を決める
航空券を探す作業にも、「目的地の欄を選ぶ」といった細かい操作があります。その場面で必要なのは、どこに、どんな操作をするかという判断です。
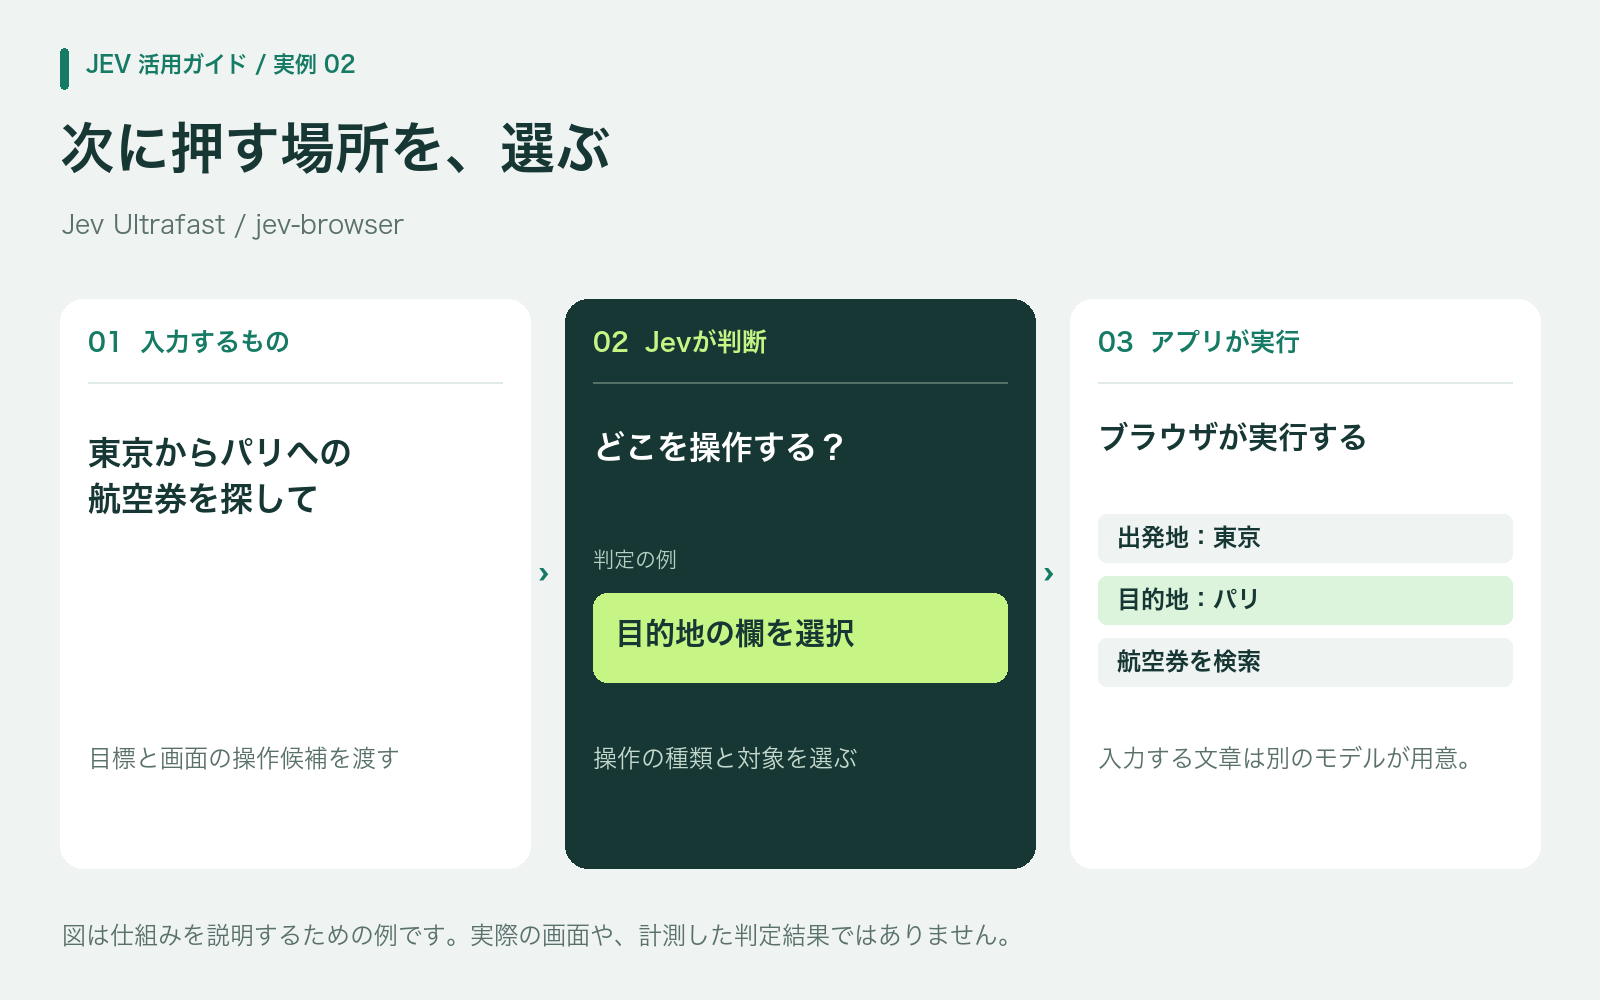
Jev Ultrafast は、ページ上の操作候補に番号を付け、Jevに操作と対象を選ばせます。文字の入力が必要な場面では、別の文章生成モデルが入力文を用意する仕組みです。
航空券検索のデモは、動きを追いやすい例です。ただ、作者が公開した長いタスクの結果では、うまくいかない場面も多かったようです。短い検索を速くこなせることと、長い用事を最後まで終えられることは、分けて見る必要があります。
jev-browser も、ブラウザ操作を分担するプロジェクトです。呼び出し元の大きなモデルが、小さな目標と必要な入力文を渡し、その中の操作判断をJevが担当します。処理が完了したのか、行き詰まったのか、確認が必要なのかを返す部分は、自分のアプリに組み込む際にも参考になりそうです。
3. どのAIモデルに仕事を頼むか、振り分ける
簡単な質問と、込み入ったコード修正を、いつも同じモデルに頼む必要はあるでしょうか。複数のモデルを使えるアプリなら、依頼の内容に応じて使い分ける方法も考えられます。
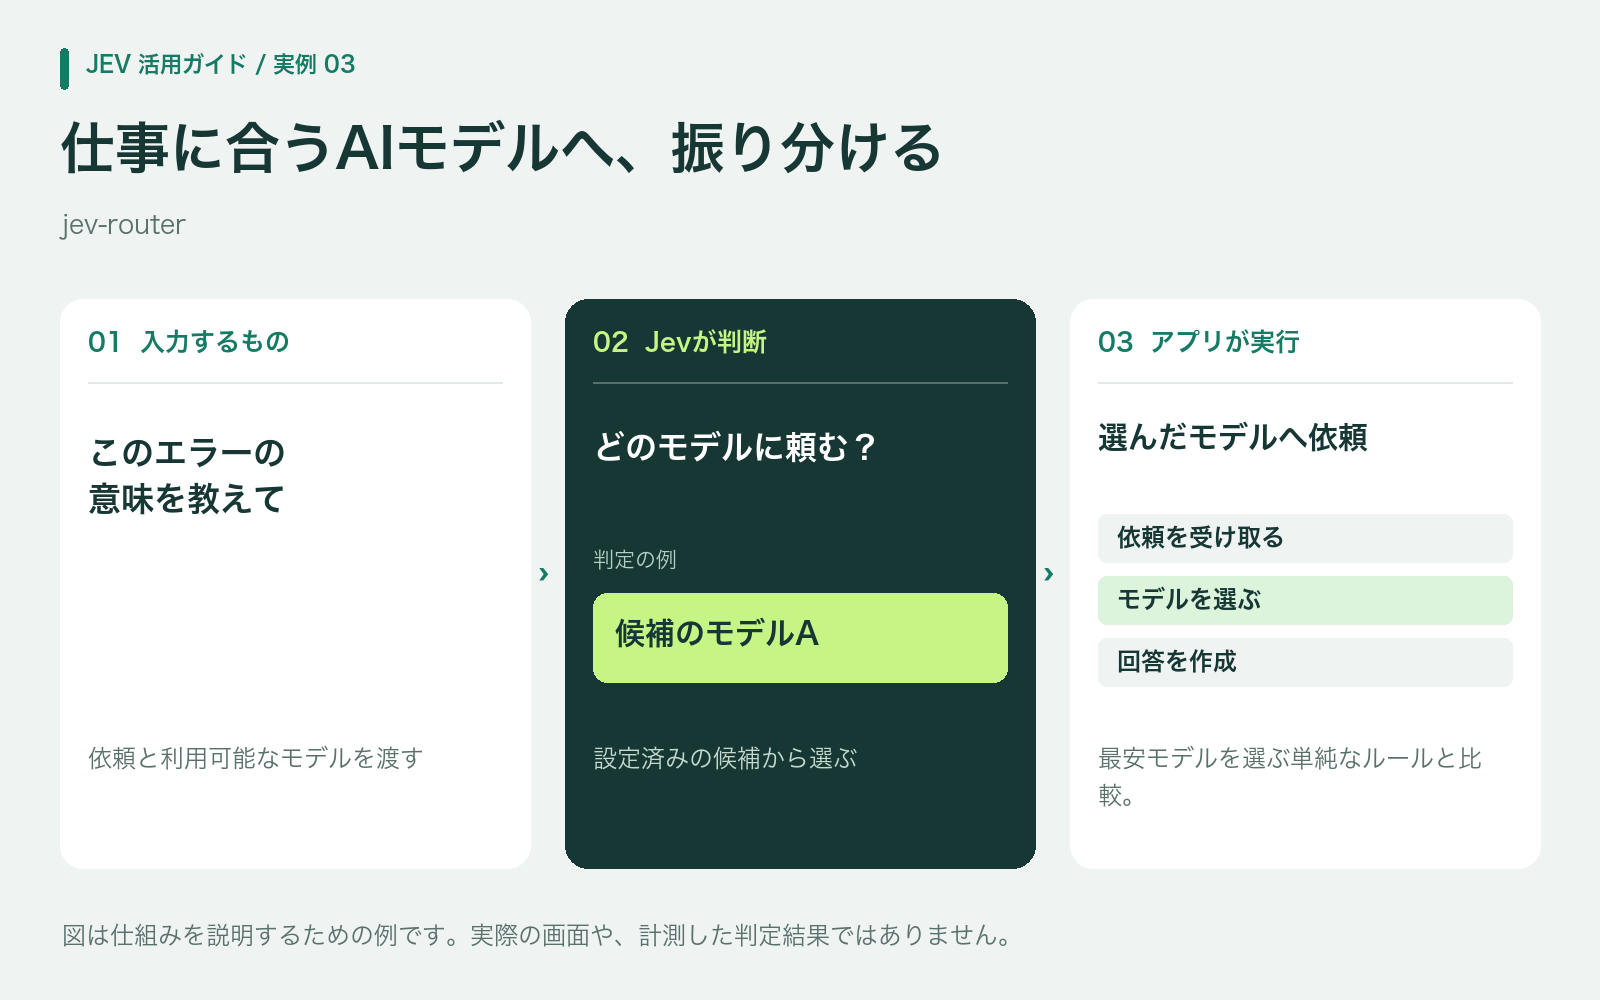
jev-router は、その振り分けを担当します。面白いと思ったのは、Jevのキーがなければ「条件を満たす中で最も安いモデルを選ぶ」という単純な方法で動くところです。
これなら、Jevに選ばせた場合と、単純なルールで選んだ場合を比べられます。まだ実験的なプロジェクトなので、僕なら、振り分けた結果として回答の質や費用がどう変わるかを確認したいです。
4. 長く作業したAIの履歴を整理する
AIに長く作業を頼んでいると、古い検索結果や、失敗したテストの出力まで履歴にたまっていきます。今の仕事に必要な情報だけ残せれば、毎回読み返す量を減らせそうです。
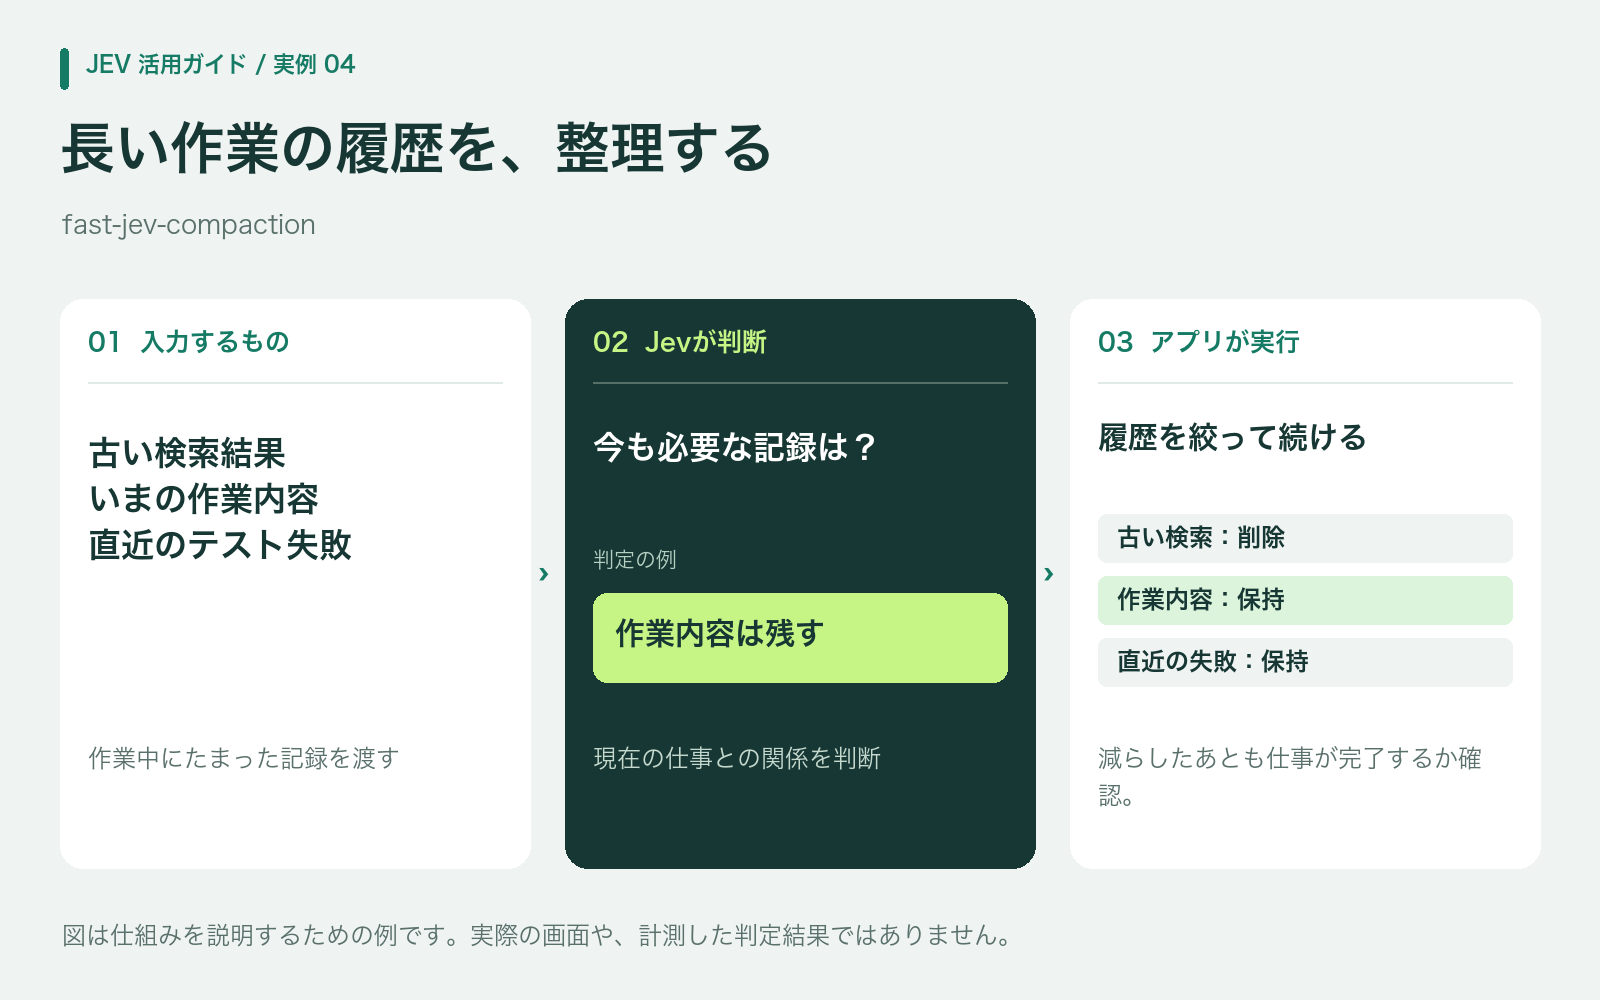
fast-jev-compaction は、こうした記録が現在の作業に必要かを判断し、不要なものを削除したり短くしたりします。
履歴がどれだけ短くなったかは、数字で確認しやすい部分です。ただ、必要な前提まで消えてしまうと困ります。試すなら、整理したあとも仕事を完了できるかまで見ておきたいです。なお、READMEのアニメーションは説明用に作られたもので、実際のAPI実行ではありません。
5. ファイル名を知らなくても、読むべきコードを探す
初めて触るコードで、「外から受け取った値を、そのままデータベースに渡している場所」を探すとします。ファイル名の見当もつかないときは、文字列検索だけではなかなか絞り込めません。
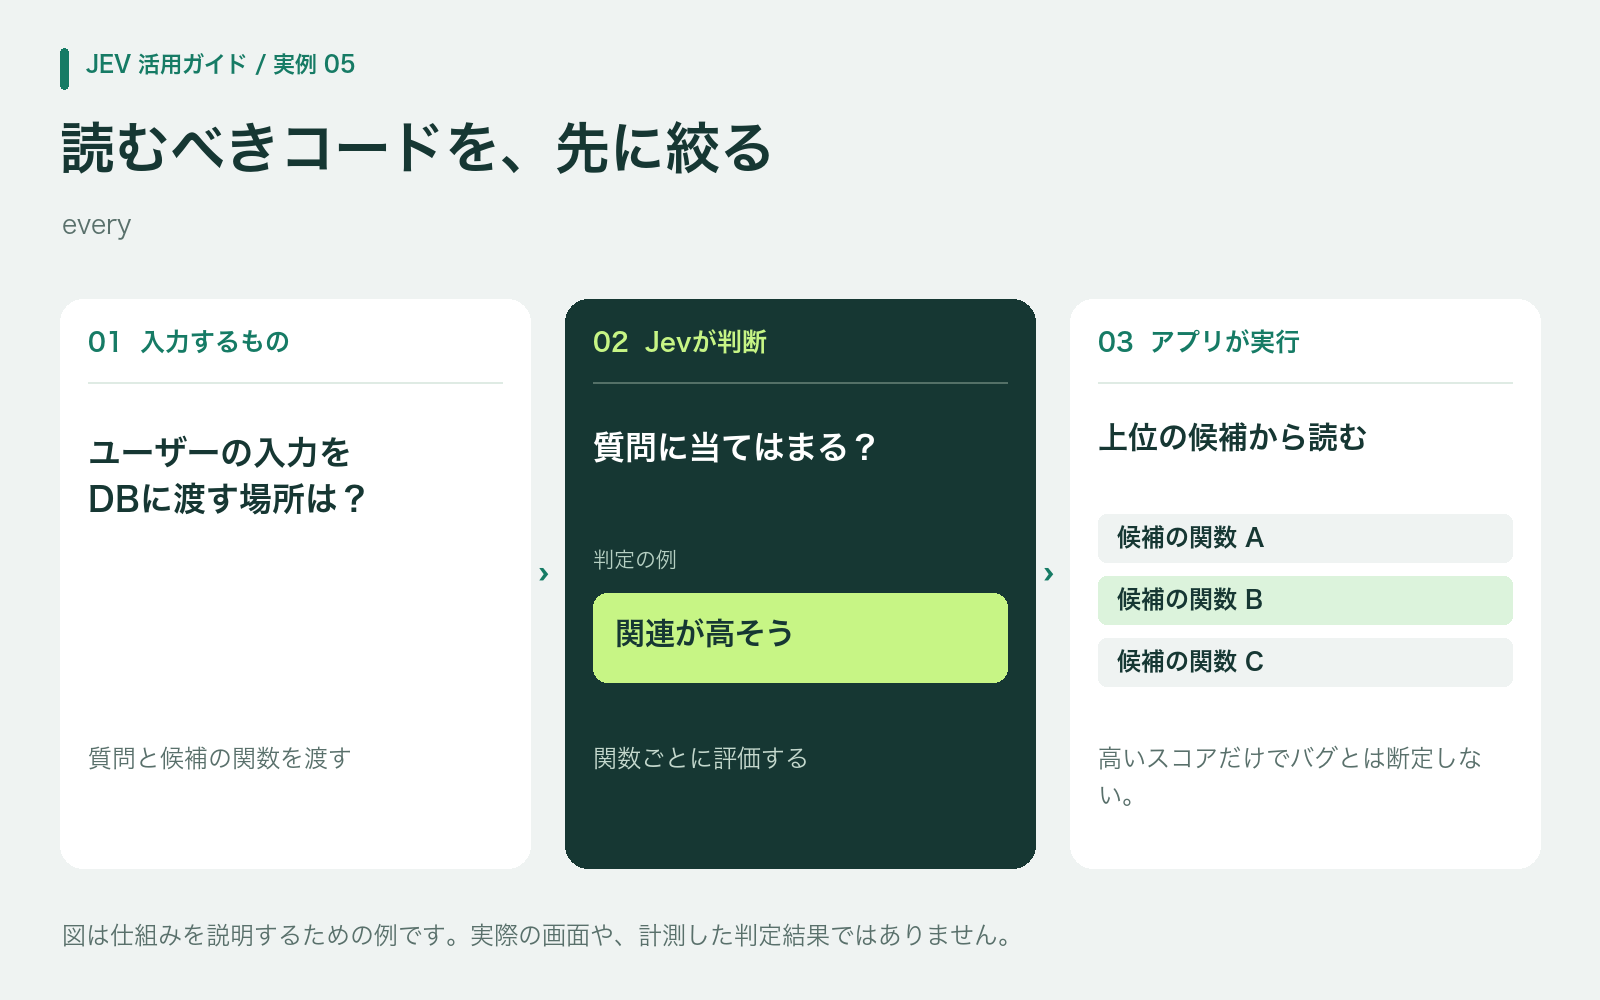
every は、コードに対する質問を受け取り、答えが「はい」である可能性が高い関数から並べてくれます。
どこから読み始めるかを決めるために使えそうです。ただし、スコアが高くても、それだけでバグが見つかったとは言えません。調べるコードをTypeSafeへ送る仕組みなので、最初は公開リポジトリで試すと流れを確認しやすいと思います。
6. 実行や掲載の前に、一度チェックする
AIがファイルを書き換えようとしているときや、まとめリストに新しいプロジェクトが投稿されたときには、決めておいた条件に合っているかを先に確認しておきたいことがあります。
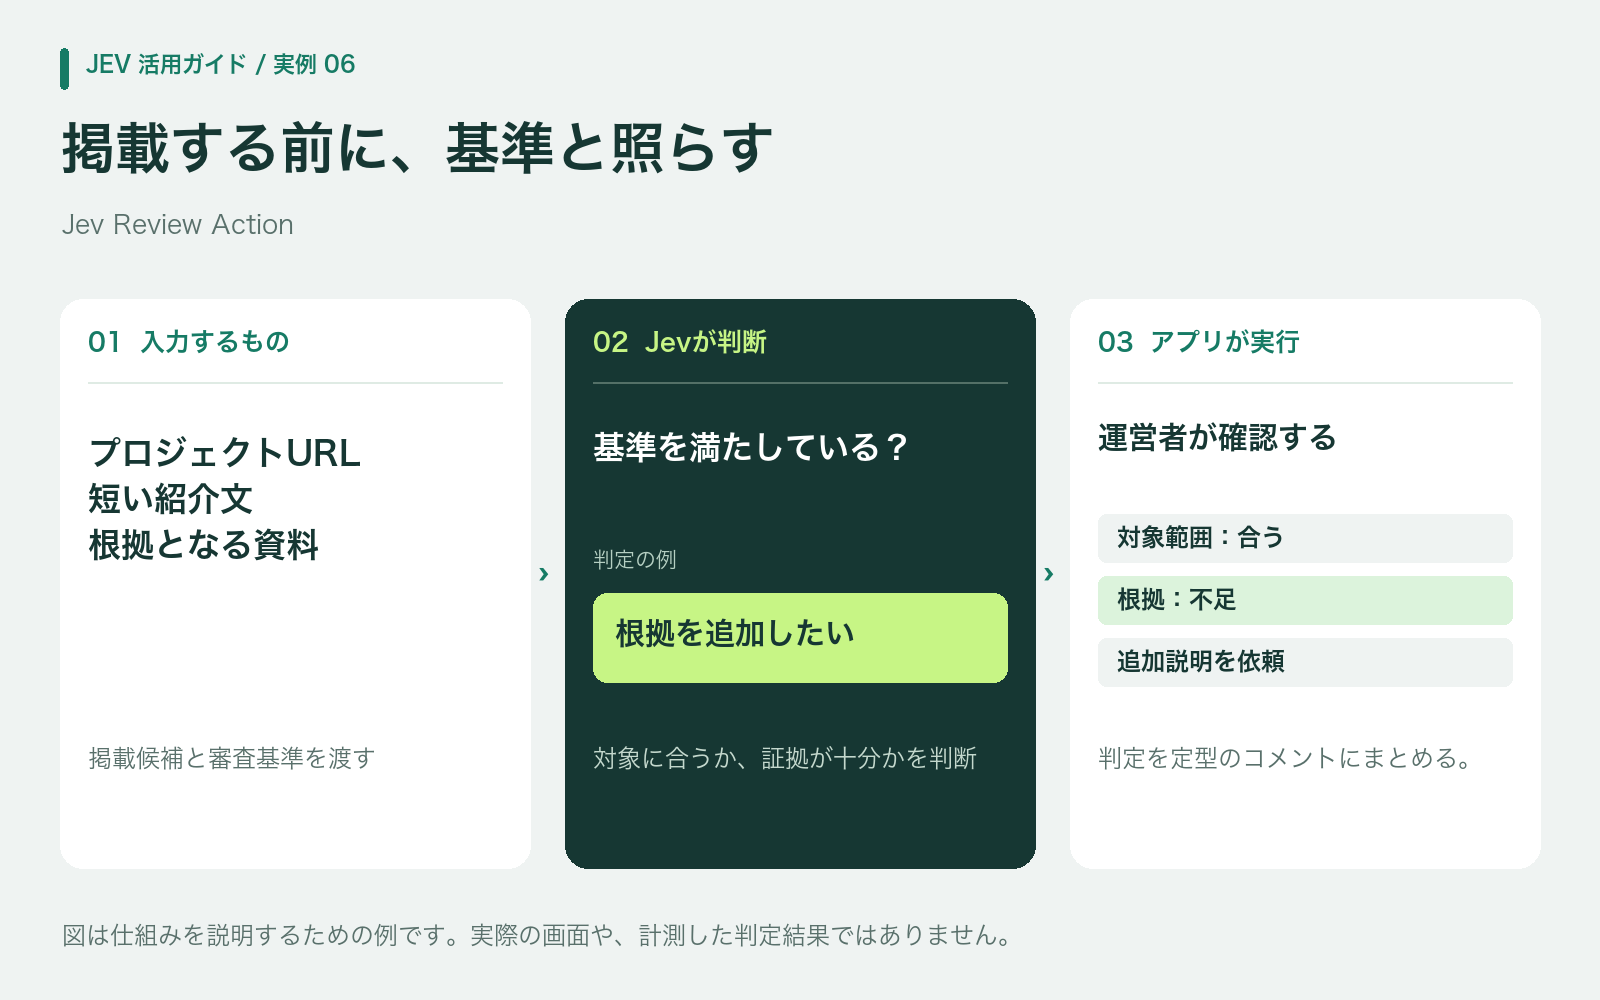
jev-guard は、AIエージェントが実行しようとする操作を確認します。ファイルへのアクセス範囲などを確かめる通常の処理に、Jevによる操作内容の評価を組み合わせています。
操作を止めず、判定だけ記録する監査モードもあります。まずはこのモードで、どんな操作が検出されるかを見られます。実際に操作を止める役割まで任せるなら、設定に加えて、判定に失敗した場合の動きも確認しておきたいところです。
Jev Review Action は、GitHubへの投稿を運営者の基準に照らして確認します。「このリストに合うか」「根拠はあるか」といった判断をJevが返し、それを決まったテンプレートに当てはめてコメントを作る仕組みです。
今回調べたまとめリストの1つでも、リストを維持するためにJevが使われています。プロジェクトを探していた場所そのものが、活用例にもなっていました。
7. 用意した部品から画面を組み立てる
画面に出す見出しや商品一覧、操作ボタンがすでに用意されているなら、あとは何をどの順に表示するかを決める作業が残ります。
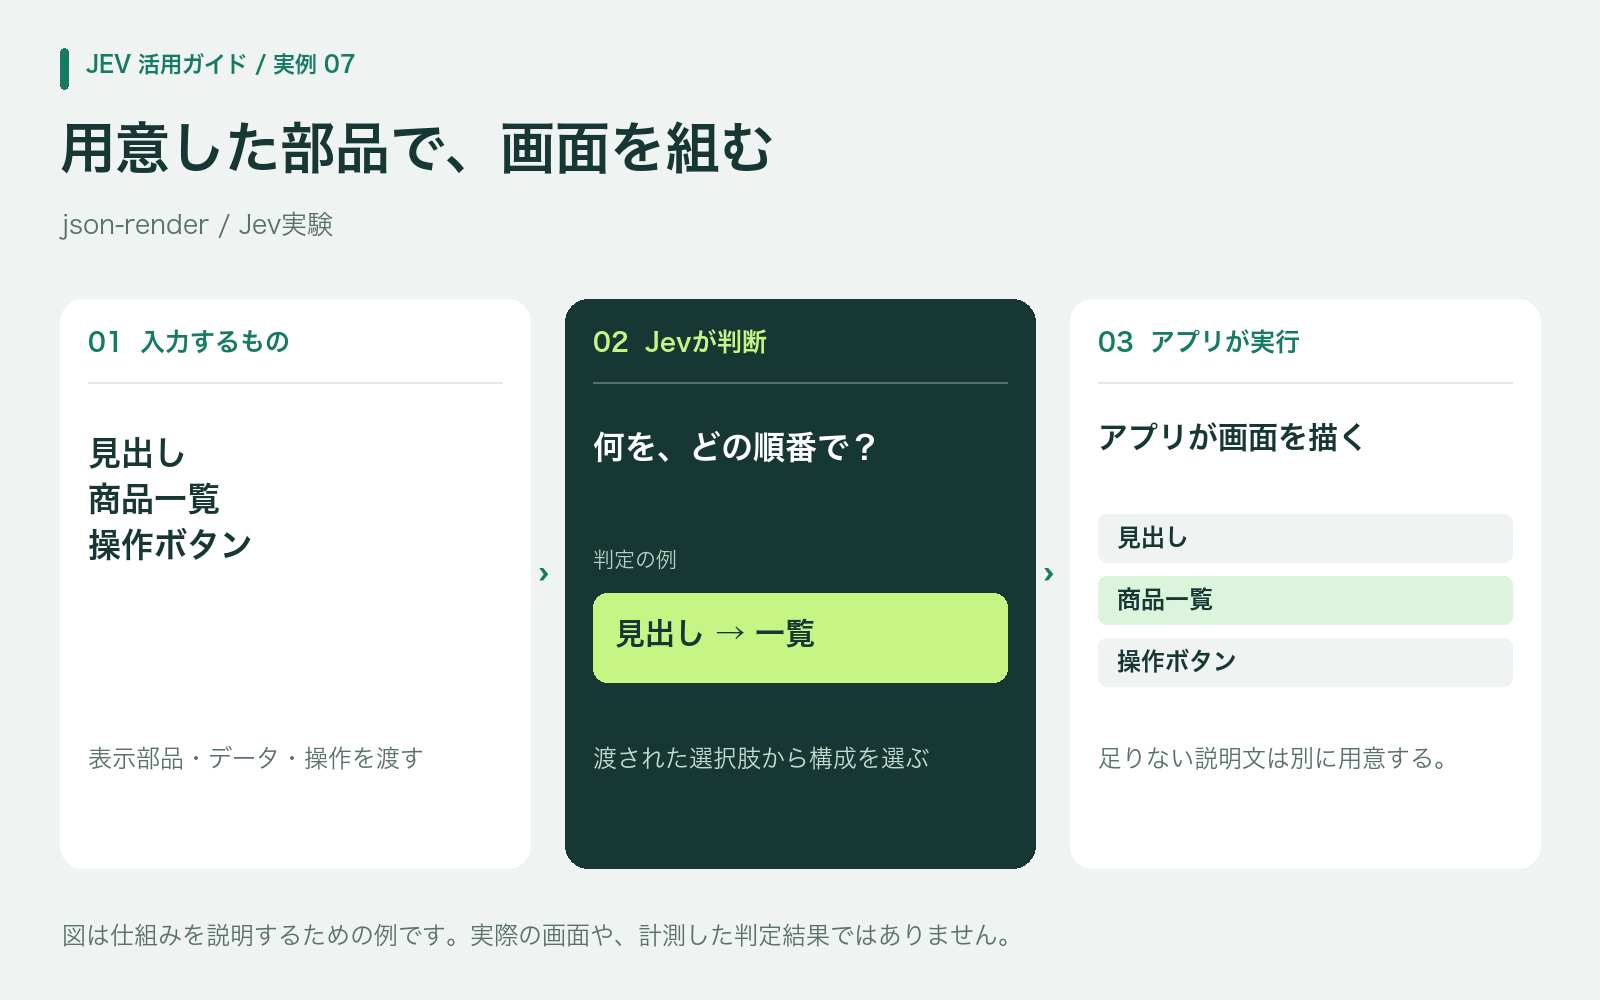
json-renderのJev実験 は、この構成を選ぶ部分を扱っています。表示部品、データ、許可された操作を渡すと、Jevが構成を選び、ソフトウェアが画面を描画します。
この仕組みでは、あらかじめ何を選択肢として渡すかが大事です。足りない説明文までJevが補ってくれるわけではありません。また、ドキュメント上は実験中・未リリースのインターフェースとされています。
8. ゲームの次の操作を選ぶ
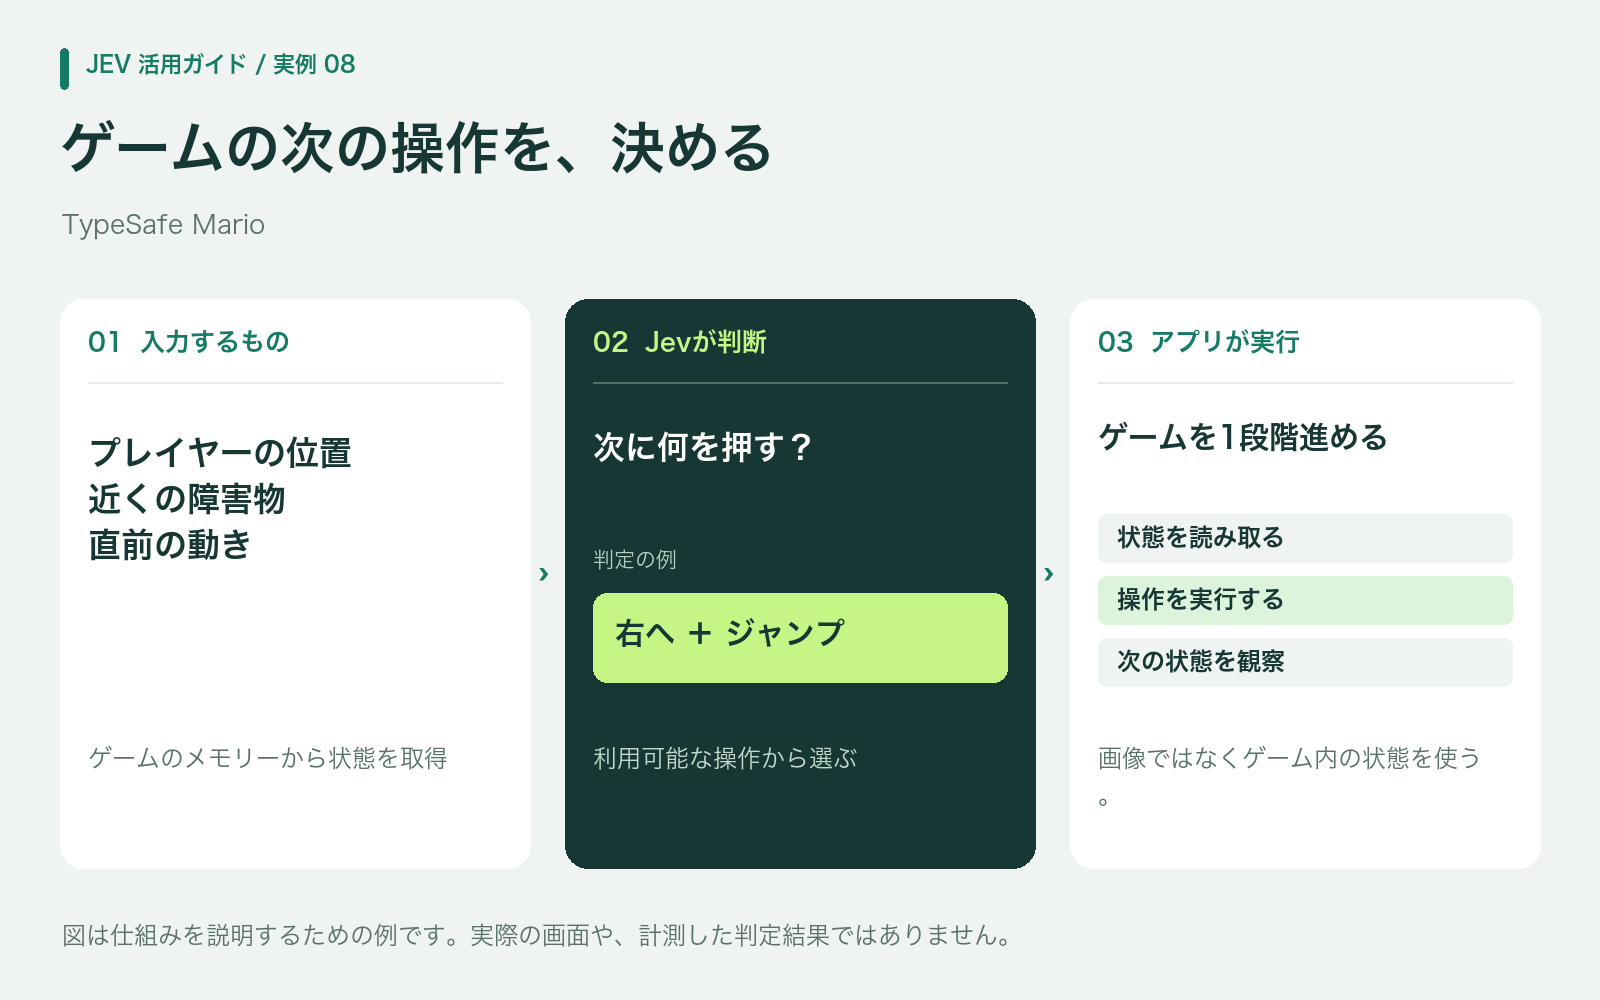
TypeSafe Mario は、マリオの位置や周囲の状況、直前の出来事を渡して、次の操作を選びます。使っているのはスクリーンショットではなく、ゲームのメモリーから取り出した情報です。
READMEにある state-demo では、ゲームやAPIを動かさずに、判断に使う情報の形を確認できます。何を選ばせるかだけでなく、判断材料をどう用意するかも含めて、作り方を読める例です。
9. 別の実装や、失敗の測り方も見る
LocalJev は、手元で動くモデルを使い、互換性のある呼び出し口を提供するプロジェクトです。同じようなリクエストを、別の環境で試せます。
ただし、同じ形式で呼べても、返ってくる判断まで同じとは限りません。READMEには、確率の値をモデルに生成させる方式と、モデル内部のスコアから取り出す方式の違いが説明されています。自分の用途で使えるかどうかは、別に確かめる必要があります。
jev-spam-eval は、正当なメール・迷惑メール・フィッシングの分類を、Jevや従来のテキスト分類器で比較しています。メールに付ける文脈によって結果がどう変わるかも調べています。
メールフィルターを作る前に、保存済みのレポートと入力データを読んでおくと参考になりそうです。実験の再実行にはAPIが必要ですが、レポートを読むだけなら不要です。なお、プロンプトの設計にはラベルの情報が使われています。比較結果は、その条件も含めて見る必要があります。
あとで探すための早見表
気になるプロジェクトが見つかったときに、どこから読めばよいかをまとめました。実行に準備が必要なものもあるので、その点も添えています。
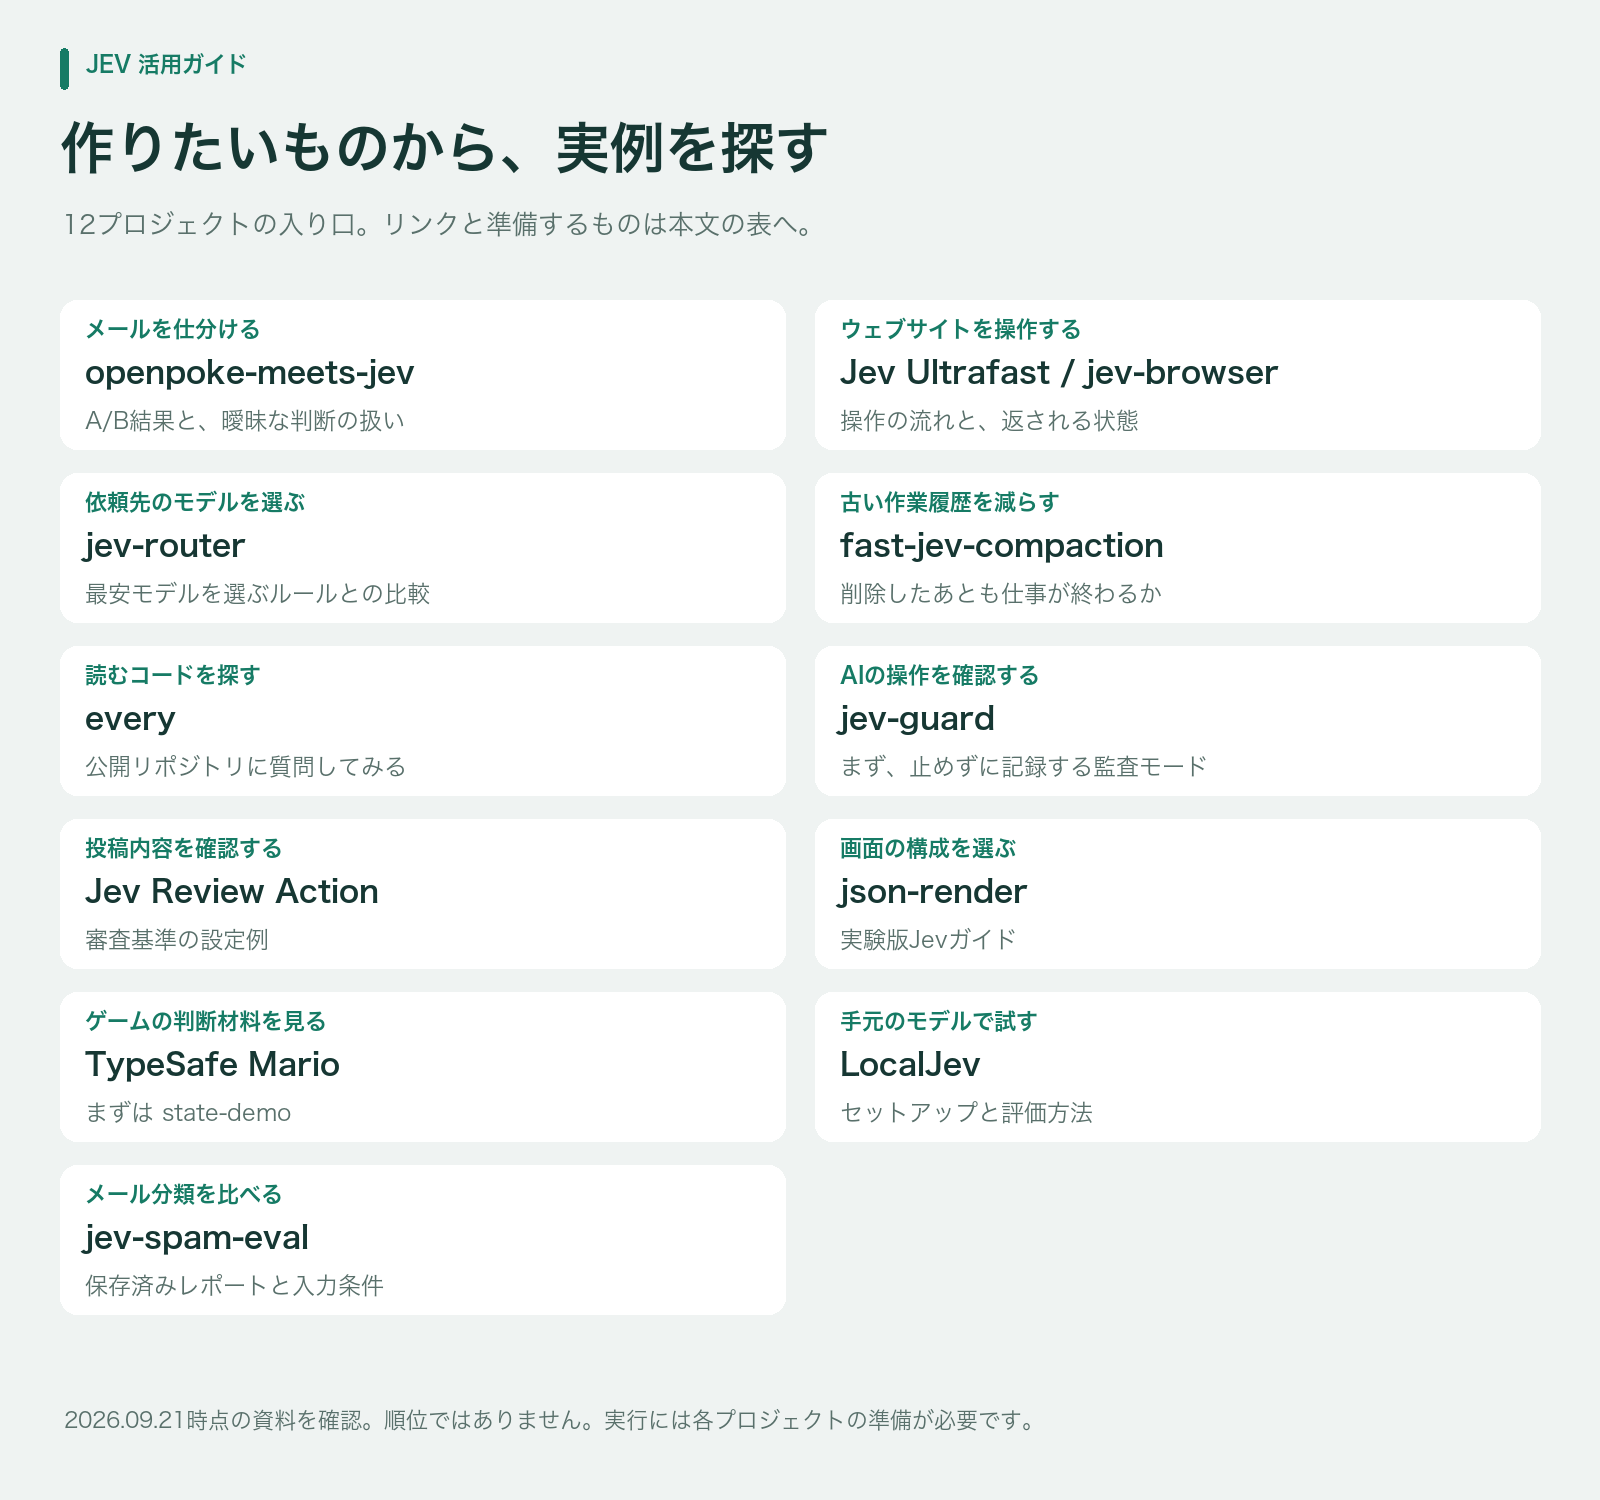
| やりたいこと | プロジェクト | 最初に見るところ・準備 |
|---|---|---|
| 通知前にメールを仕分ける | openpoke-meets-jev | A/B結果と判断が曖昧な場合の処理。実行にはOpenPokeの設定とTypeSafeへの接続が必要 |
| ウェブサイトを操作する | Jev Ultrafast | 航空券検索の例。ブラウザ環境とJev・文章生成モデルを用意する |
| 既存のAIにブラウザ操作を足す | jev-browser | 渡す目標と返る状態。TypeSafeのキーとブラウザが必要 |
| 依頼先のAIモデルを選ぶ | jev-router | 最安モデルを選ぶ単純な方法との比較。利用するモデルの接続設定が必要 |
| 作業履歴を減らす | fast-jev-compaction | 何を残すかと組み込み方。アニメーションはAPIなしで見られる |
| 読むべきコードを探す | every | 公開リポジトリへの質問。PythonとAPI接続が必要。対象コードは外部へ送られる |
| AIの操作を事前に確認する | jev-guard | 止めずに記録する監査モード。対応するエージェントと接続設定が必要 |
| リストへの投稿を確認する | Jev Review Action | 審査基準の設定例。GitHub ActionsとAPIの設定が必要 |
| 既存の部品で画面を構成する | json-render | 実験版のガイド。ソースからのビルドと接続設定が必要 |
| ゲームの判断材料を見る | TypeSafe Mario | まず state-demo。プレイには追加の環境設定が必要 |
| 手元のモデルで試す | LocalJev | セットアップと評価方法。ローカルのモデルサーバーとBunが必要 |
| メール分類の失敗を調べる | jev-spam-eval | 保存済みレポートと入力条件。Jevでの再実行にはAPI接続が必要 |
自分のアプリに入れるなら、何から考えるか
今回調べてみて、ブラウザ操作以外にも、アプリの途中にある判断をJevに任せる例が多いと感じました。履歴を残すか削るか、どのコードを先に読むかなど、普段の作業にも当てはめて考えやすい使い方です。
僕が自分のアプリに入れるなら、まず「どの判断を改善したいのか」と「今はどんなルールで決めているか」を書き出すところから始めます。
メールなら件名や送信者で振り分ける方法、モデル選択なら条件を満たす最安モデルを選ぶ方法が、比較相手になります。待ち時間や費用がどう変わるかに加えて、仕事を最後まで終えられるか、必要な情報を落としていないかも確かめたいです。
ここで紹介したものとは違う使い方を作っていたら、GitHubやDEVで教えてもらえるとうれしいです。リポジトリのリンクに「Jevに何を決めさせているか」を一言添えてもらえると、仕組みを追いやすくて助かります。
集計方法と出典
集計の対象は、2026年9月21日時点の、9つのREADMEのプロジェクト掲載部分です。主なGitHubリポジトリのリンクを数え、別のawesomeリスト、バッジ、補足の根拠リンク、汎用カタログツールの my-stars-atlas は除外しました。GitHubへのリンクがない記事やデモも対象外です。
所有者名とリポジトリ名は小文字にそろえ、末尾の .git を除きました。各リスト内では同じアドレスを1回だけ数え、forkは別として扱っています。改名されたリポジトリが異なるアドレスで残っている場合も、自動的には同一視していません。
今回わかるのは、選んだREADMEの掲載状況までです。Jevの全プロジェクトを調べたものではなく、利用者数や成長率も示していません。既存フレームワークにはJevに対応する前からスターが付いている場合があるため、その数をJevの利用実績として扱うことも避けています。
集計データと数え方は、公開Gistにまとめています。抽出した1,186件のアドレス、集計のルール、取得時の内容を識別するハッシュ、17カテゴリーから8分類への対応を確認できます。
参照したリスト:fatwang2、logicrw、yzfly、walidboulanouar、daftAI2026、BeatAPI、RadRebelSam、yangzhou-chaofan、evan87863。
Shinです。日本で個人開発をしています。以前は米国スタートアップのCTO、日本のスタートアップのCPOを務めていました。GitHubに作っているものを、DEVに英語の記事を置いています。
調査・文章の下書き・図の制作にはAIも使っています。上記のOpenPokeの実装と実験は僕自身のものです。グラフはリストの集計結果、フロー図は仕組みを説明するための図です。